Pesquisa3 de novembro de 20266 min de leitura
Perguntamos a cada documento qual é o assunto dele. Um em cada quatro não foi encontrado
Para saber se a memória melhora, precisávamos de um número que não dependesse de opinião. Usamos o próprio documento como pergunta. O resultado mostrou três erros no instrumento antes de mostrar um problema no produto.
"Melhorou" é fácil de dizer e difícil de provar. O acervo de um cliente não vem com gabarito: ninguém sabe qual documento deveria responder cada pergunta. Os benchmarks públicos medem outro acervo, escrito por outra pessoa, com outra dúvida na cabeça.
A saída foi construir a verdade que o próprio acervo permite. Para cada documento, a pergunta é o assunto dele, título mais o começo do corpo. A resposta certa é aquele documento. Se a busca não acha um documento a partir do assunto dele, não vai achar a partir de uma pergunta de verdade.
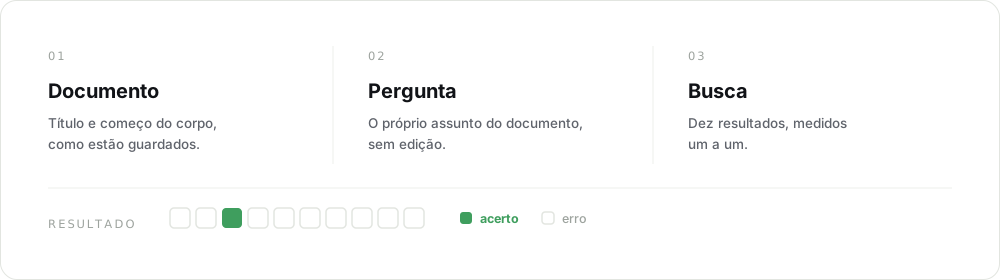
Isso é um piso, não um teto. Não mede se o contexto responde, nem se o modelo que lê acerta. Mede uma coisa só: o documento alcança quem pergunta.
Três erros no instrumento antes do primeiro número
A primeira rodada deu zero por cento de acerto em 100 documentos. Zero é absurdo o suficiente para eu desconfiar do instrumento antes de desconfiar do produto.
O erro estava na comparação: eu confrontava o caminho guardado no banco com o caminho que a busca devolve, e a busca devolve o caminho com a coleção na frente. Nenhum documento casava. Corrigido isso, o número subiu para quase 50%.
A segunda rodada deu números diferentes a cada execução, porque o sorteio de documentos não tinha semente. Duas medições do mesmo sistema não eram comparáveis.
A terceira foi mais sutil. A pergunta que eu montava começava com o texto cru do documento, e boa parte dos documentos de reunião começa com um cabeçalho repetido, do tipo "Índice do acervo, não é fonte". Eu estava pedindo que a busca achasse o cabeçalho.
Só depois dos três consertos o número passou a significar alguma coisa.
O que sobrou quando o instrumento ficou de pé
Um em cada quatro documentos não aparecia nem entre os dez primeiros resultados, com o próprio assunto como pergunta. As duas causas eram de produto, não de medição.
A primeira: o filtro que evita entregar dois documentos parecidos. Ele comparava o texto e, quando dois documentos falavam do mesmo cliente ou da mesma reunião, tratava o segundo como se fosse uma versão do primeiro e o empurrava para o fim da fila. Na prática, o documento que respondia saía da frente por parecer com outro. Agora o filtro só rebaixa versão anterior do mesmo documento, quando a data prova qual é o novo, ou cópia quase idêntica.
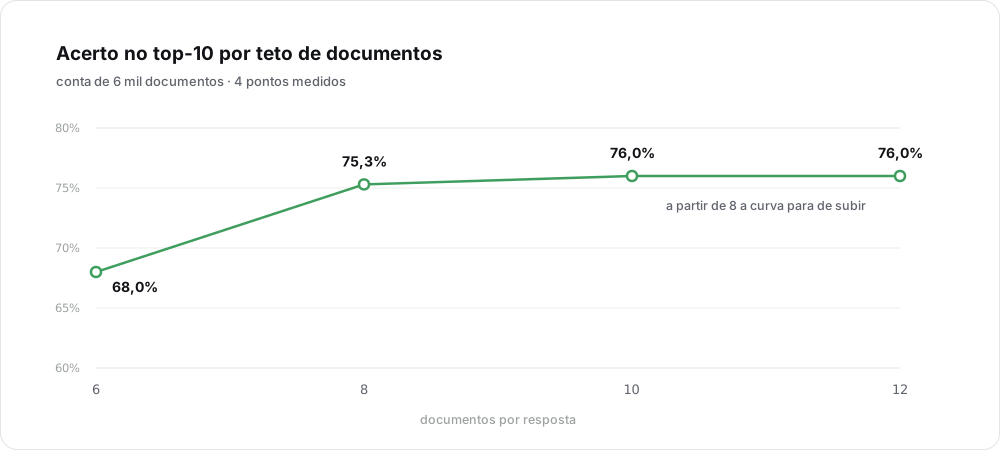
A segunda: o teto de documentos por resposta. Baixar de 12 para 6 parecia bom no banco de testes, onde a resposta quase sempre está no topo. No acervo real, com 6 mil documentos, custava sete pontos de acerto. O teto ficou em 8, que é onde a curva para de subir num acervo grande e ainda entrega menos contexto do que 12.
O número, e o que ele não diz
Depois das correções, a chance de o documento certo aparecer entre os dez primeiros passou de 79% para 84% na conta que usamos como referência, com o contexto cerca de 30% menor do que era com 12 documentos.
Esse número não diz se a resposta está certa. Recuperar o documento é condição para responder, não a resposta. Também não diz se o leitor aproveita o que recebeu, e a pergunta que usamos é sintética, feita do assunto do documento, não da dúvida de uma pessoa.
O que ele diz é onde estava o problema e quanto custava. Antes, a discussão sobre escopo e ranqueamento era opinião contra opinião. Agora existe uma régua que qualquer pessoa pode rodar no próprio acervo e comparar com a nossa.
Próximo passo
Menos recomeço. Mais continuidade
Leve um projeto real. Em uma conversa, mapeamos onde o contexto se perde entre as pessoas e os agentes do seu time, e por onde começar.