Investigación3 de noviembre de 20266 min de lectura
Le preguntamos a cada documento de qué trata. Uno de cada cuatro no fue encontrado
Para saber si la memoria mejora, necesitábamos un número que no dependiera de la opinión. Usamos el propio documento como pregunta. El resultado mostró tres errores en el instrumento antes de mostrar un problema en el producto.
"Mejoró" es fácil de decir y difícil de probar. El acervo de un cliente no viene con respuestas: nadie sabe qué documento debería responder cada pregunta. Los benchmarks públicos miden otro acervo, escrito por otra persona, con otra duda en la cabeza.
La salida fue construir la verdad que el propio acervo permite. Para cada documento, la pregunta es su asunto, título más el comienzo del cuerpo. La respuesta correcta es ese documento. Si la búsqueda no encuentra un documento a partir de su propio asunto, tampoco lo encontrará a partir de una pregunta real.
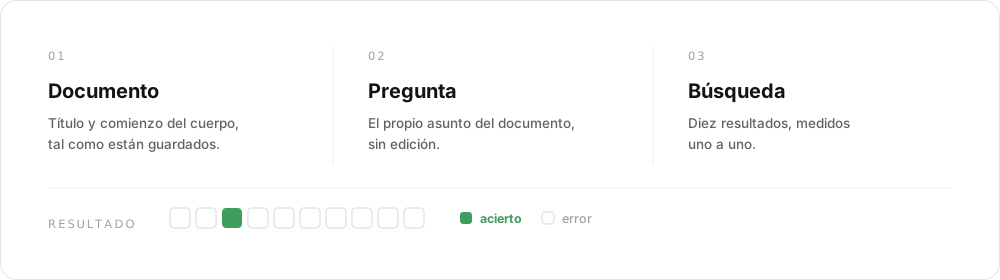
Esto es un piso, no un techo. No mide si el contexto responde, ni si el modelo que lee acierta. Mide una sola cosa: si el documento llega a quien pregunta.
Tres errores en el instrumento antes del primer número
La primera ronda dio cero por ciento de acierto en 100 documentos. Cero es lo bastante absurdo para desconfiar del instrumento antes de desconfiar del producto.
El error estaba en la comparación: yo confrontaba el camino guardado en la base con el camino que devuelve la búsqueda, y la búsqueda devuelve el camino con la colección delante. Ningún documento coincidía. Corregido eso, el número subió a casi 50%.
La segunda ronda daba números distintos en cada ejecución, porque el sorteo de documentos no tenía semilla. Dos mediciones del mismo sistema no eran comparables.
La tercera fue más sutil. La pregunta que armaba empezaba con el texto crudo del documento, y buena parte de los documentos de reunión empieza con un encabezado repetido, del tipo "Índice del acervo, no es fuente". Le estaba pidiendo a la búsqueda que encontrara el encabezado.
Solo después de las tres correcciones el número pasó a significar algo.
Lo que quedó cuando el instrumento se sostuvo
Uno de cada cuatro documentos no aparecía ni entre los diez primeros resultados, con su propio asunto como pregunta. Las dos causas estaban en el producto, no en la medición.
La primera: el filtro que evita entregar dos documentos parecidos. Comparaba el texto y, cuando dos documentos hablaban del mismo cliente o de la misma reunión, trataba al segundo como si fuera una versión del primero y lo empujaba al final de la cola. En la práctica, el documento que respondía quedaba atrás por parecerse a otro. Ahora el filtro solo relega una versión anterior del mismo documento, cuando la fecha prueba cuál es el nuevo, o una copia casi idéntica.
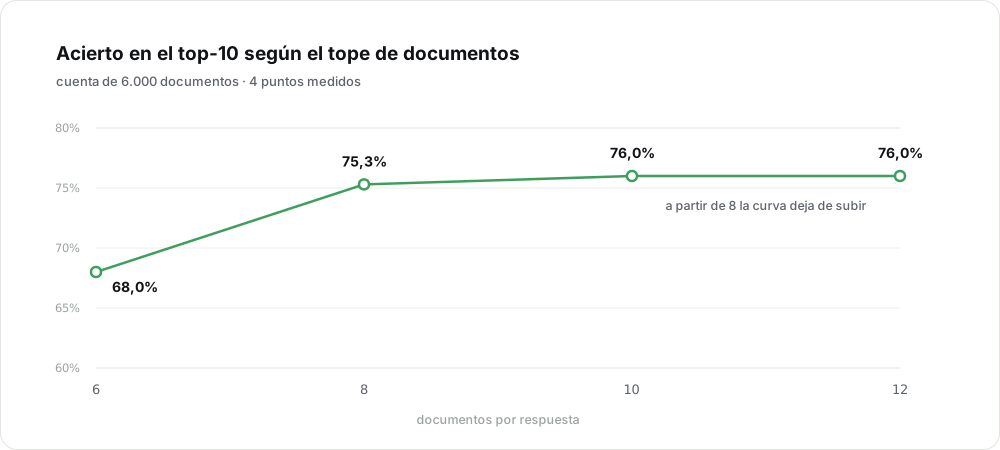
La segunda: el tope de documentos por respuesta. Bajar de 12 a 6 parecía bueno en el banco de pruebas, donde la respuesta casi siempre está arriba. En el acervo real, con 6.000 documentos, costaba siete puntos de acierto. El tope quedó en 8, donde la curva deja de subir en un acervo grande y el contexto entregado sigue siendo menor que con 12.
El número, y lo que no dice
Después de las correcciones, la probabilidad de que el documento correcto aparezca entre los diez primeros pasó de 79% a 84% en la cuenta que usamos como referencia, con un contexto cerca de 30% menor que con 12 documentos.
Ese número no dice si la respuesta es correcta. Recuperar el documento es condición para responder, no la respuesta. Tampoco dice si el lector aprovecha lo que recibió, y la pregunta que usamos es sintética, hecha del asunto del documento, no de la duda de una persona.
Lo que sí dice es dónde estaba el problema y cuánto costaba. Antes, la discusión sobre alcance y ranking era opinión contra opinión. Ahora existe una regla que cualquiera puede correr en su propio acervo y comparar con la nuestra.
Próximo paso
Menos volver a empezar. Más continuidad
Trae un proyecto real. En una conversación mapeamos dónde se pierde el contexto entre las personas y los agentes de tu equipo, y por dónde empezar.